Sürüm: 0.21.0Bu dokümantasyon Spitfire 0.21.0 içindir.
Gözlemlenebilirlik (OpenTelemetry, Prometheus, Tempo, Jaeger, Loki)
Yük testi size "p95 900 ms oldu" der; neden olduğunu söylemez. Bu sayfa, sistemlerinizin
zaten ürettiği trace, metric ve log verisini Spitfire'a bağlayarak root cause'a nasıl
yaklaşacağınızı anlatır: OTLP receiver, Prometheus (ve Grafana Mimir, Thanos,
VictoriaMetrics), Tempo, Jaeger, Loki, traceparent, koşu sayfasındaki Backend sekmesi,
kırılma noktası bulguları ve grafiklerdeki kaynak overlay'i.
Ne işe yarar
- Spitfire kendi ajanını kurmaz. Yük testi sırasında sistemlerinizin ürettiği observability verisini yalnızca açık standartlar ve açık araçlarla okur.
- Bu veriyi koşunun yük basamaklarıyla (VU seviyeleri ya da gelme hızı basamakları) hizalar: "450 VU basamağında orders-db p95 18 ms → 410 ms".
- Sistem kırıldığında, o anda hangi kaynağın doyduğunu ya da sıçradığını sıralar: "Sistem 560 VU'da kırıldı; aynı anda orders-db connection pool'u doldu (bekleyen bağlantı 0 → 48) ve checkout CPU'su %41 → %97'ye çıktı."
traceparentaçıkken testin en yavaş ve hatalı isteklerini sizin trace'lerinizde bulur.
Spitfire "aynı anda" der, asla "çünkü" demez. Ölçülen ile ölçülmeyen arasındaki farkı korur; veri yoksa bunu söyler.
Ne zaman kullanılır
- Bir eşik kırıldığında ya da kırılma noktası bulunduğunda darboğazın nerede olduğunu görmek için.
- Karşılaştırmalı koşuda B kolunun neden yavaş olduğunu backend tarafında görmek için (Sürüm karşılaştırma).
- Zaten OpenTelemetry Collector, Prometheus, Tempo/Jaeger ya da Loki kullanıyorsanız: kurulum birkaç dakikadır.
Bağlantı türleri
| Bağlantı | Yön | Spitfire'ın kullandığı |
|---|---|---|
| OTLP alıcısı | OpenTelemetry Collector'ınız → Spitfire | trace'ler, metrikler (gauge, sum), hata ve uyarı logları |
| Prometheus (ve uyumlular: Grafana Mimir, Thanos, VictoriaMetrics) | Spitfire → /api/v1/query_range |
PromQL'iniz: servis başına gecikme (p95), hata oranı, kaynaklar |
| Tempo | Spitfire → /api/search (TraceQL), /api/traces/{id} |
her basamağın trace'lerinden bir örnek |
| Jaeger | Spitfire → sorgu API'si /api/traces |
her basamağın trace'lerinden bir örnek |
| Loki | Spitfire → /loki/api/v1/query_range |
servis başına hata satırlarını sayan metrik LogQL |
İki çalışma şekli vardır:
- OTLP alıcısı (push): Collector'ınız veriyi Spitfire'a gönderir. Spitfire yalnızca bir koşu penceresine (başlangıçtan 30 sn önce ile bitişten 60 sn sonrası) düşen veriyi saklar.
- Sorgu bağlantıları (pull): Spitfire koşu bittikten sonra (geç gelen veri için 90 sn sonra) yalnızca koşunun penceresini sorgular. Bir yönetici Backend sekmesinden yeniden hesaplatabilir.
Hangisini seçmeliyim? Zaten bir Collector'ınız varsa en zengin veri OTLP alıcısıyla gelir (trace, metric ve log birlikte). Collector'a dokunamıyorsanız mevcut Prometheus/Tempo/Loki'nize sorgu bağlantısı ekleyin. İkisi birlikte de kullanılabilir.
Bağlantı ekleme
Observability sayfası yalnızca admin'e açıktır: sol menüde Altyapı → Observability.
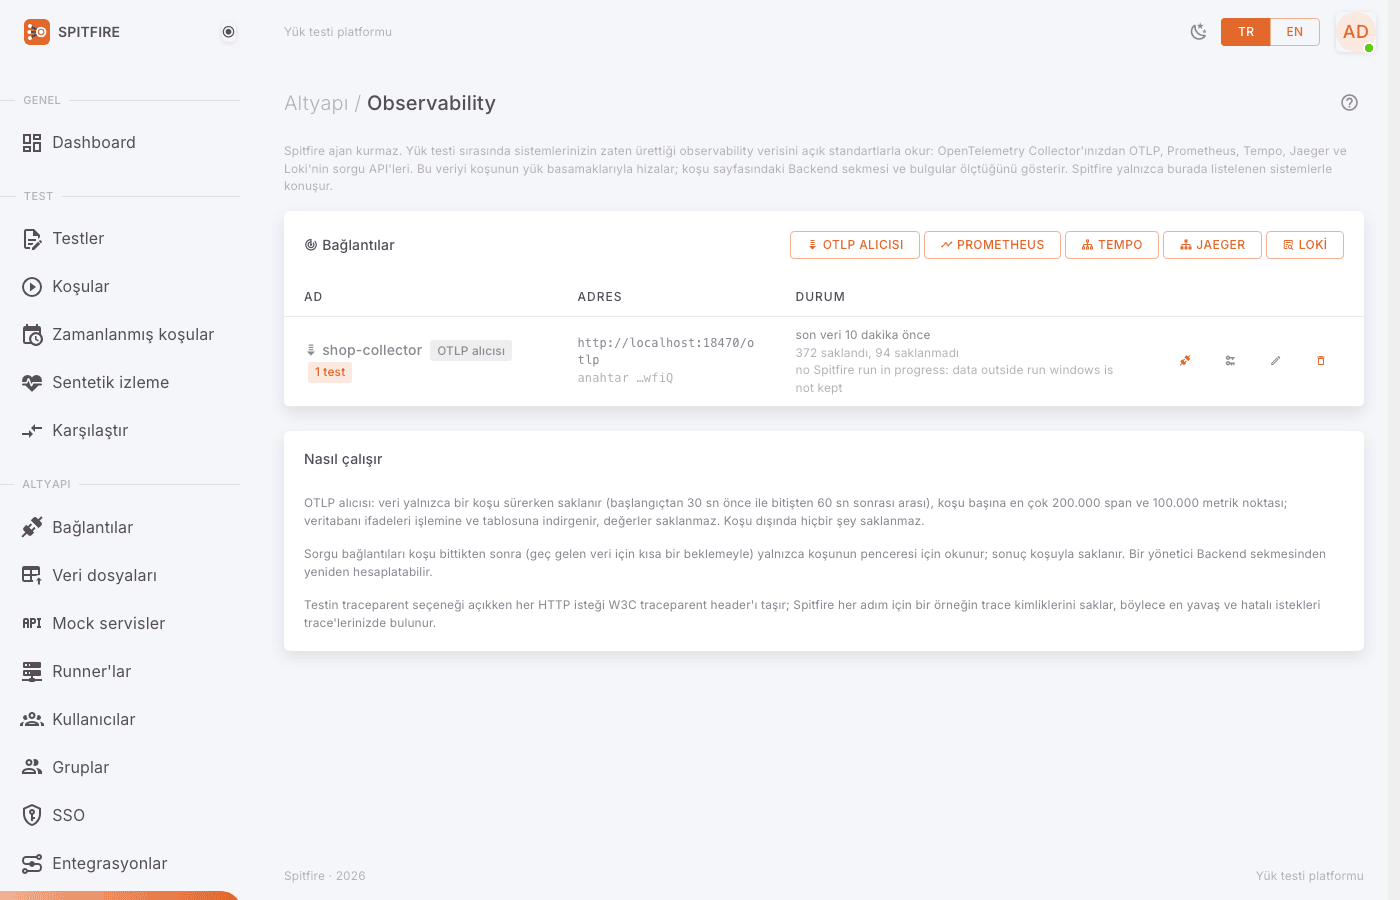 Observability sayfası
Ortak adımlar:
- Observability sayfasındaki Bağlantılar kartının başlığında eklemek istediğiniz türün düğmesine basın: OTLP alıcısı, Prometheus, Tempo, Jaeger ya da Loki.
- Ad verin (ör. "prod-collector", "mimir-team-a").
- Türe göre alanları doldurun (aşağıdaki bölümler).
- Açık işaretli olsun, Kaydet'e basın.
- Sorgu bağlantılarında listede Bağlantıyı dene ile adresin ve kimlik bilgilerinin doğru olduğunu kontrol edin.
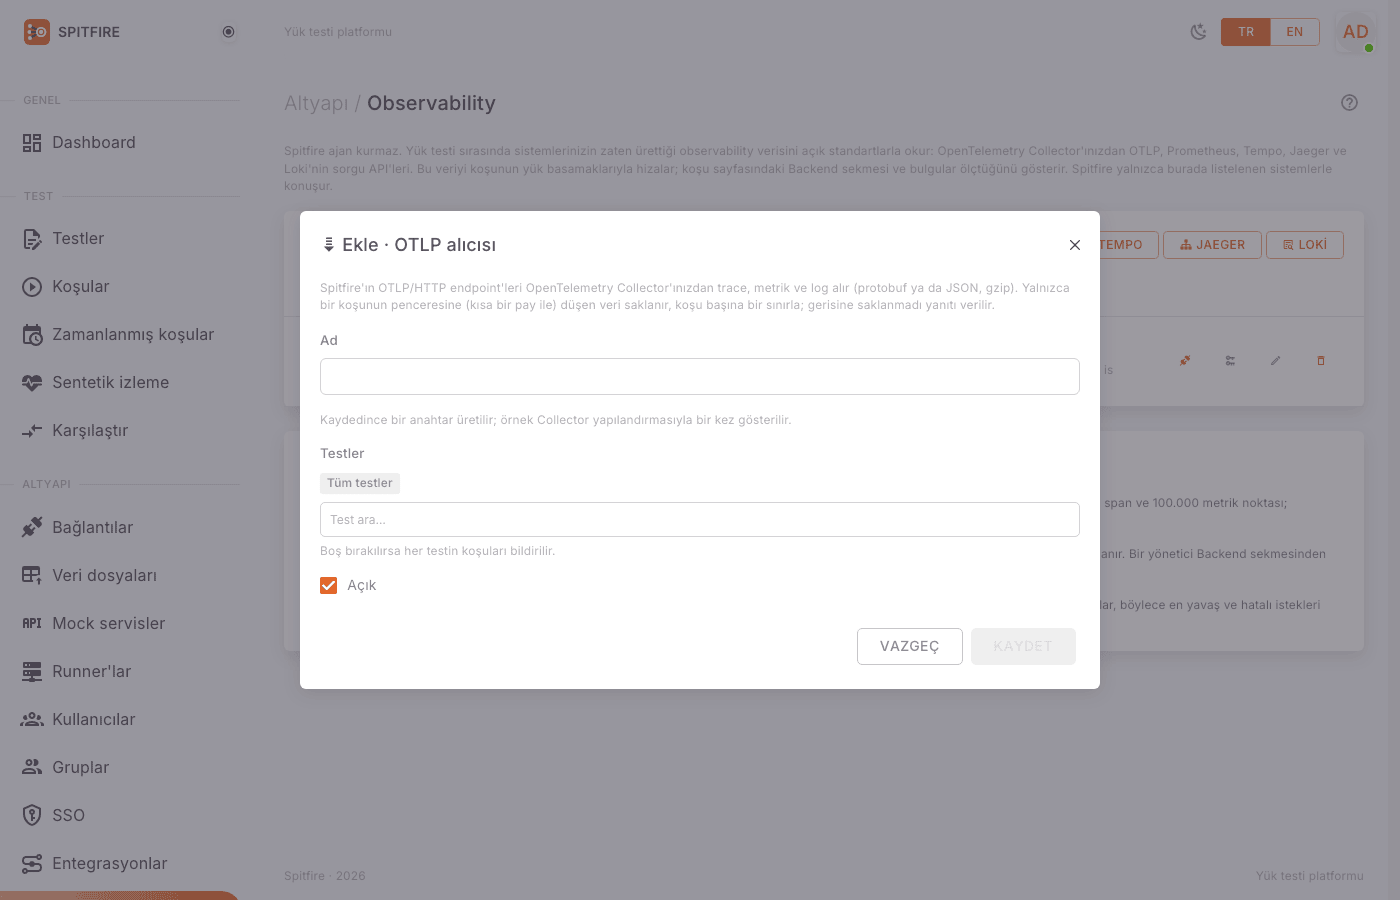 Bağlantı ekleme penceresi
Anahtar ve parolalar, bağlantı sırları gibi SPITFIRE_SECRET_KEY ile şifrelenir. Kayıtlı anahtar
ya da parola, boş bırakılırsa ve adres aynı sunucuda kaldıkça korunur.
OTLP alıcısı (OpenTelemetry Collector)
Spitfire HTTP portunda /otlp/v1/traces, /otlp/v1/metrics ve /otlp/v1/logs adreslerinde
OTLP/HTTP sunar (protobuf ya da JSON, gzip'li ya da değil).
Ekle → OTLP alıcısı, bir ad verin ve kaydedin.
Kaydedince bir anahtar (
sfotlp_…) üretilir ve örnek Collector yapılandırmasıyla bir kez gösterilir. Anahtarı şimdi kopyalayın: bir daha gösterilmez (yalnızca özeti saklanır).Collector'ınıza mevcut exporter'ların yanına bir tane ekleyin:
exporters:
  otlphttp/spitfire:
    endpoint: https://spitfire.example.com/otlp   # dışa aktarıcı /v1/traces vb. ekler
    headers:
      Authorization: "Bearer sfotlp_…"
    compression: gzip

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/spitfire]   # ve mevcut dışa aktarıcılarınız
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/spitfire]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/spitfire]
Collector'ı yeniden başlatın ve Tamam'a basın.
Bir koşu başlatın. Listede bağlantının yanında "son veri …" ve "x saklandı, y saklanmadı" görünür; koşu dışında gelen veri saklanmaz (bu normaldir).
Sınırlar: koşu başına en çok 200.000 span ve 100.000 metric noktası, gönderim başına 16 MB.
Gerisine reddedildi yanıtı verilir (OTLP partial success), Collector yeniden denemez. Veritabanı
ifadeleri işlemine ve tablosuna indirgenir (SELECT … FROM order_items); değerler hiç saklanmaz.
Anahtar sızarsa listede Yeni anahtar'a basın. Şimdiki anahtar hemen geçersiz olur; Collector yapılandırmasını yenisiyle güncelleyin.
Prometheus, Grafana Mimir, Thanos, VictoriaMetrics
Hepsini tek bir Prometheus bağlantısı karşılar; sorgu API'sinin yol öneki bağlantının URL'sinde yazılır.
- Ekle → Prometheus.
- Adres'i yazın:
- Prometheus:
http://prometheus:9090 - Grafana Mimir:
/prometheusönekiyle, ör.http://mimir-query-frontend:8080/prometheus. Spitfirehttp://mimir-query-frontend:8080/prometheus/api/v1/query_rangeadresini çağırır. - Thanos:
http://thanos-query:9090 - VictoriaMetrics:
http://victoria-metrics:8428
- Prometheus:
- Kimlik doğrulama: Yok, Bearer anahtarı, Kullanıcı adı ve parola ya da Header'da anahtar (Header adı ile).
- Çok kiracılıysa (Mimir) Kiracı (X-Scope-OrgID) alanına kiracıyı yazın (ör.
team-a). - Sorgular bölümünde Sorgu ekle ile her sorgu için:
- Ne ölçer: Gecikme (p95), Hata oranı ya da Kaynak.
- PromQL ifadesini yazın.
$__intervalsorgu adımıyla değiştirilir. - İsteğe bağlı servis; kaynakta ad (ör. CPU) ve birim. Servis yazılmazsa her seri servis etiketiyle adlandırılır.
- Hazır örnekler için Örnek: … düğmelerini kullanın.
- Kaydedin ve Bağlantıyı dene'ye basın.
PromQL örnekleri:
# Servis başına gecikme (saniye) — Gecikme (p95)
histogram_quantile(0.95, sum by (le, service_name) (rate(http_server_request_duration_seconds_bucket[$__interval])))

# Hata oranı
sum by (service_name) (rate(http_server_request_duration_seconds_count{http_response_status_code=~"5.."}[$__interval])) / sum by (service_name) (rate(http_server_request_duration_seconds_count[$__interval]))

# Kaynak: CPU zamanı
sum by (service_name) (rate(process_cpu_time_seconds_total[$__interval]))

# Kaynak: bir pod'un CPU'su limitine oranla (0,95 ve üstü doymuş sayılır)
sum by (pod) (rate(container_cpu_usage_seconds_total{container!=""}[$__interval])) / sum by (pod) (kube_pod_container_resource_limits{resource="cpu"})

# Kaynak: veritabanı bağlantısı bekleyen istekler (OpenTelemetry DB client metrikleri)
sum by (service_name, db_client_connection_pool_name) (db_client_connection_pending_requests)Root cause sıralaması en çok CPU (limitine oranla), bellek, connection pool'da bekleyen istekler ve kuyruk derinliği (depth, lag, backlog) metriklerinden yararlanır. En az bunları Kaynak olarak ekleyin.
Tempo
- Ekle → Tempo, adresi (ör.
http://tempo:3200) ve gerekiyorsa kimlik doğrulamayı ve Kiracı (X-Scope-OrgID)'yı girin. - TraceQL sorgusu her yük basamağı için çalışır.
{}her trace'i bulur; servislerinize daraltın:{ resource.service.name = "orders" }. - Basamak başına trace: her basamaktan kaç trace okunacağı.
Jaeger
- Ekle → Jaeger, sorgu API'sinin adresini girin.
- Servisler: virgülle ayrılmış servis adları. Boş bırakılırsa sorgu API'sinin listelediği her servis (en çok 20) okunur.
- Basamak başına trace'i ayarlayın.
Loki
Ekle → Loki, adresi ve gerekirse Kiracı (X-Scope-OrgID)'yı girin.
Servis etiketine göre gruplanmış metrik döndüren bir LogQL yazın (
count_over_time,rate…):sum by (service_name) (count_over_time({service_name=~".+"} |~ "(?i)(error|exception|fatal)" [$__interval]))Servis etiketi: servisi adlandıran etiket. Boş bırakılırsa
service_name,service,jobya daappdenenir.
traceparent: testin isteklerini trace'lerinizde bulmak
Testte traceparent açıkken her HTTP isteği, adım kendisi koymadıkça W3C traceparent header'ı
taşır (sampled bayrağı açık). Runner'lar her adım ve 10 sn için en yavaş ve ilk hatalı isteğin trace
kimliğini saklar (runner başına en çok 2.000, koşu başına 5.000). Backend sekmesi bu istekleri
trace'lerinizde bulur: servisin kendi süresi ve altındaki en yavaş span.
Açmak için:
- Testi Düzenle ile açın, Seçenekler sekmesine geçin.
- traceparent header'ı alanında Açık: HTTP isteklerinde W3C traceparent (örneklenmiş)'ı seçin.
- Kaydedin.
JSON'da karşılığı:
{ "options": { "traceparent": "on" } }Varsayılan kapalıdır: açıkken her test isteği trace'inin saklanmasını ister. Yük testi hacminde bu, trace backend'inizde yer tutabilir. Trace saklama kapasitenizi düşünerek açın.
Servislerinizin gelen traceparent header'ını kabul edip trace bağlamını aktardığından
(context propagation) emin olun; OpenTelemetry SDK'ları bunu varsayılan olarak yapar.
Backend sekmesini okumak
Koşu sayfasında Backend sekmesi, yük basamağı başına şunları gösterir:
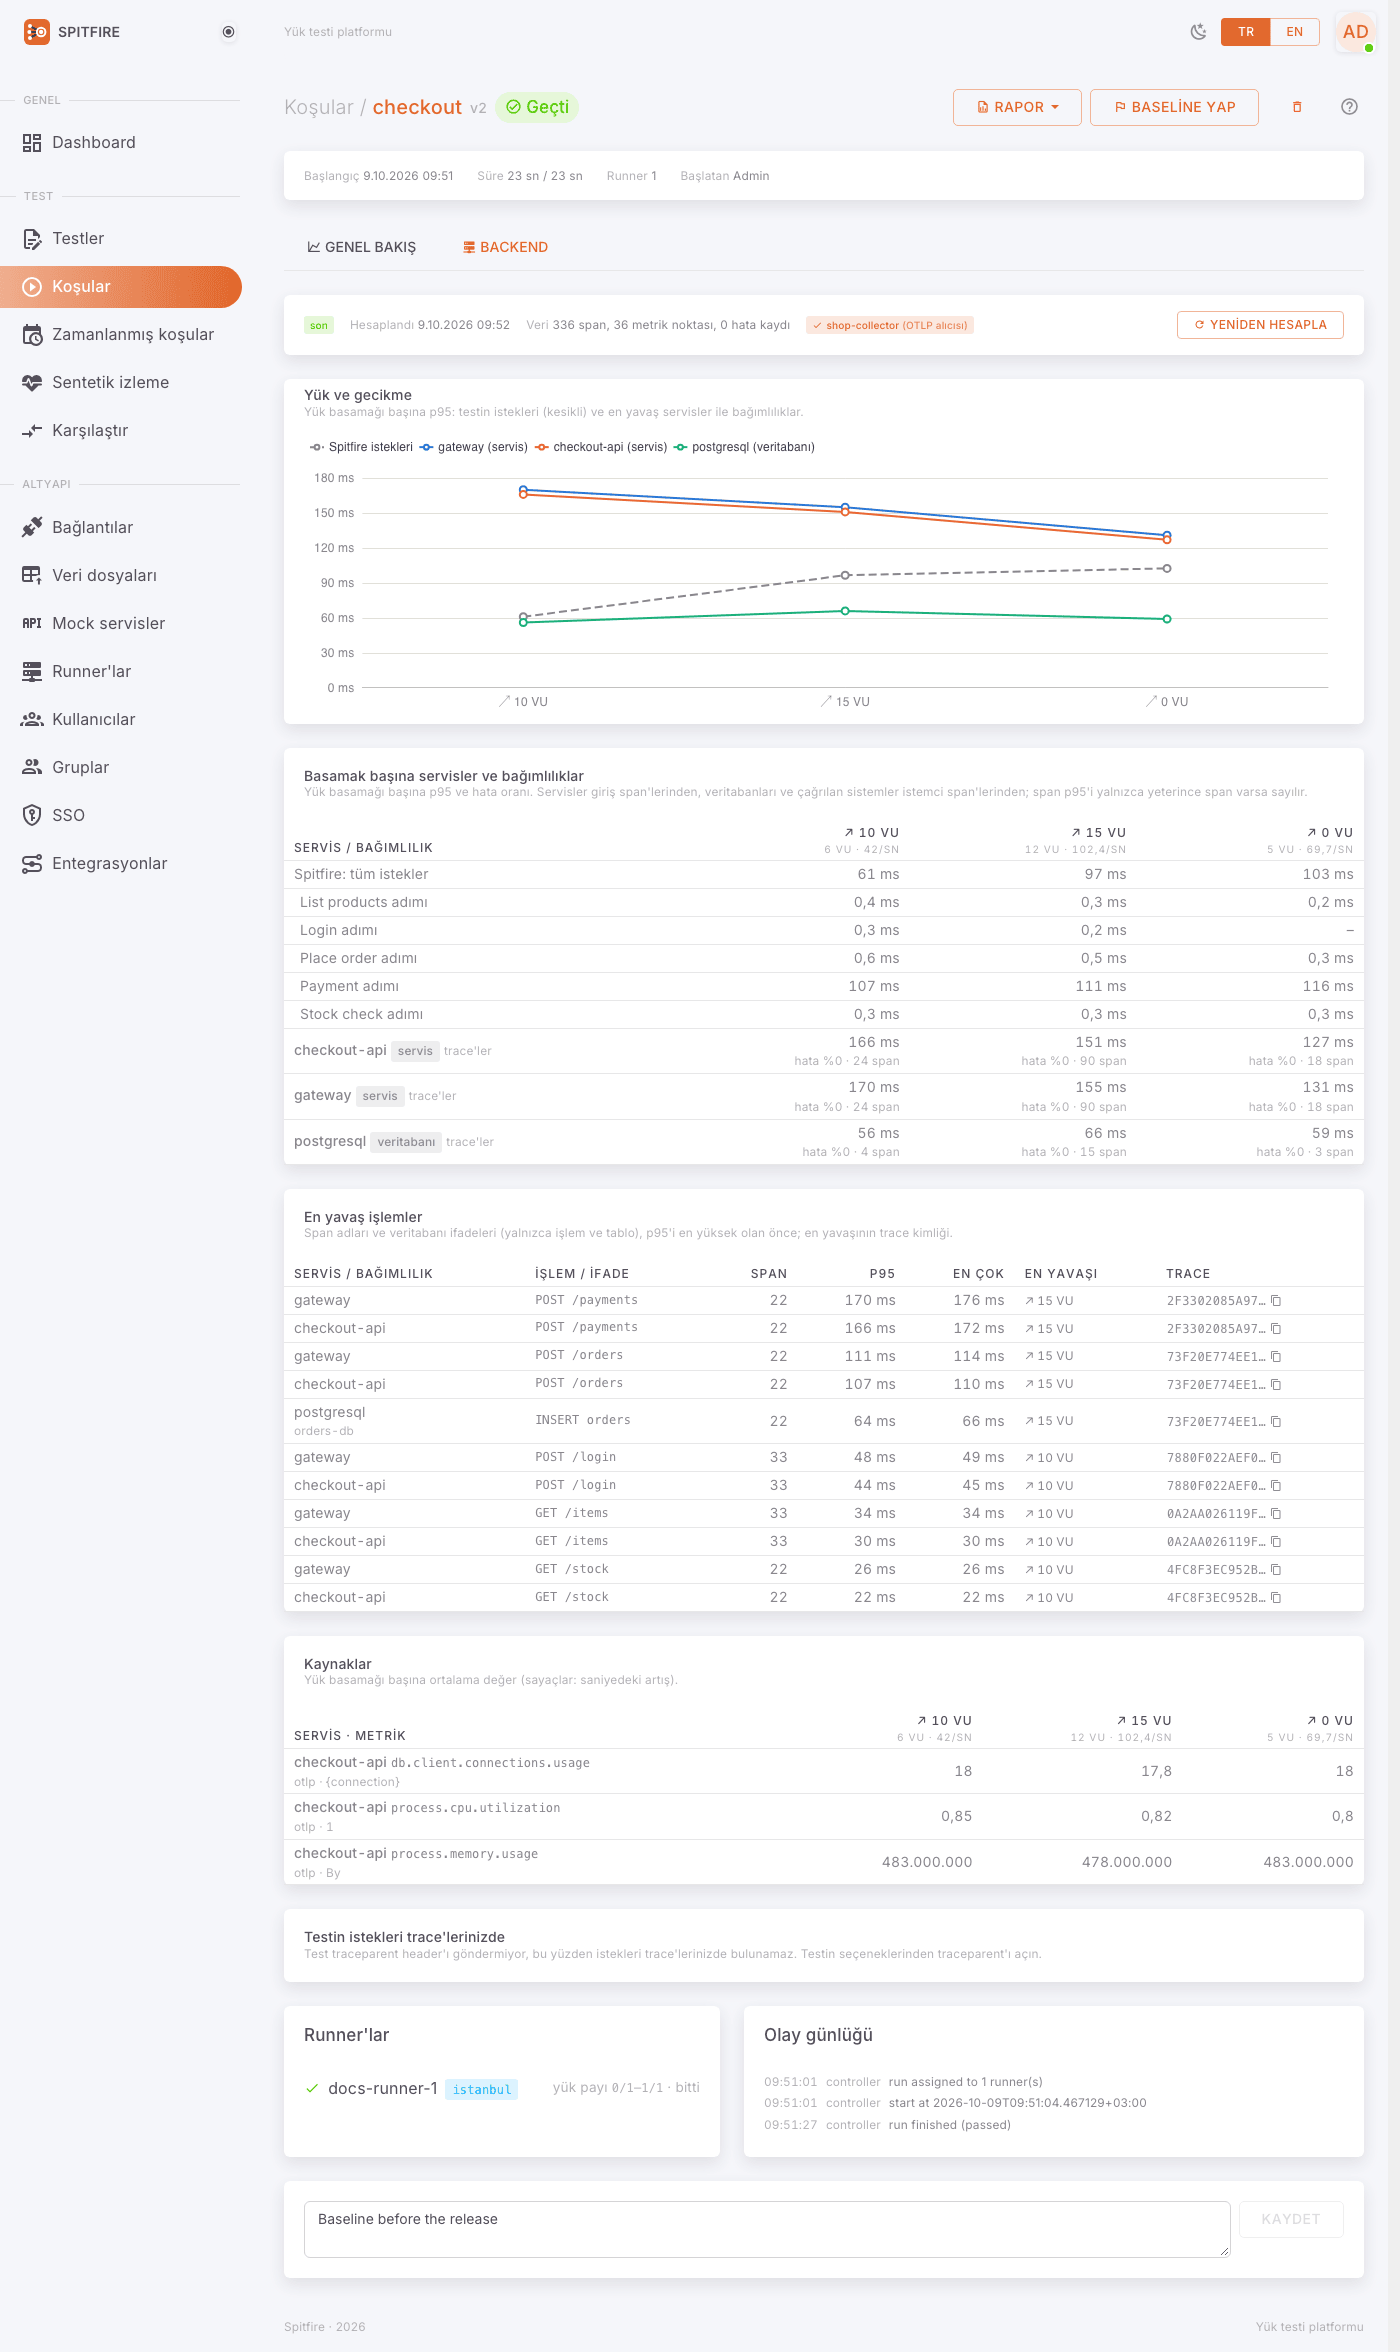 Backend sekmesi
- Üstte durum: canlı: yalnızca gelen veri (koşu sürüyor), geç gelen veri bekleniyor, son ya da bağlantı yok. Veri satırı kaç span, metric noktası ve hata kaydı geldiğini yazar.
- Yük ve gecikme: yük basamağı başına p95 — testin istekleri (kesikli) ve en yavaş servisler ile bağımlılıklar.
- Basamak başına servisler ve bağımlılıklar: her servisin (giriş span'leri), veritabanının ve çağrılan sistemin (istemci span'leri) ya da Prometheus sorgusunun p95'i ve hata oranı. Spitfire: tüm istekler satırı karşılaştırma içindir.
- En yavaş işlemler: span adları ve veritabanı ifadeleri, p95'i en yüksek olan önce; en yavaşının Trace kimliği (kopyalayıp Tempo/Jaeger'da açın).
- Kaynaklar: yük basamağı başına ortalama değer (sayaçlar saniyedeki artışıyla).
- Hata logları: servis ve basamak başına hata kayıtları, örnekleriyle.
- Testin istekleri trace'lerinizde: saklanan trace kimliği sayısı ve bulunanlar; her biri için Testin ölçtüğü süre, Servisin süresi ve Altındaki en yavaş span.
Sağ üstteki Yeniden hesapla (yönetici) sorgu bağlantılarını yeniden okur; ör. bir sorguyu düzelttikten sonra.
Backend bulguları koşu bulgularının kuralına uyar: yalnızca verinin gösterdiği, rakamlarıyla. Örnek:
450 VU basamağında orders-db (veritabanı) p95 18 ms → 410 ms (240 span). Aynı anda checkout adımı eşiği aştı: p95 520 ms, sınır 300 ms. En yavaş işlem:
SELECT … FROM order_items.
Root cause sıralaması (kırılma noktası)
Koşu kırıldığında — başarısız bir p95 ya da hata oranı eşiği (req_duration p(95)<…,
req_failed rate<…; koşunun tamamında ya da bir adımda) veya kırılma noktası koşusunun geçemediği
adım — Spitfire kırıldığı yük basamağını ve ondan önceki aynı türden basamağı alır, bağlı tüm
kaynaklardan gelen her kaynak serisini şöyle sıralar:
- mutlak doygunluk: limitinin %95'i ve üstünde CPU, %90 ve üstünde bellek, havuzdan bağlantı bekleyen istekler (sıfırın üstünde ve artmış), en az iki katına çıkıp 10'u geçen bir kuyruk (depth, lag, backlog);
- sonra önceki basamağa göre en büyük göreli sıçrama (en az 1,5 kat; sıfırdan çıkış en büyük sayılır).
En üstteki üçü tek bir bulguya yazılır:
Sistem 560 VU'da kırıldı (p95 eşiği aşıldı: 900 ms, sınır 500 ms); aynı anda orders-db connection pool'u doldu (bekleyen bağlantı 0 → 48) ve checkout CPU'su %41 → %97'ye çıktı.
Hiçbir seri oynamadıysa bunu, o an için kaynak verisi yoksa onu söyler. VU sınırı yüzünden (sistem değil) duran bir kırılma noktası koşusunun kırılma noktası yoktur. Sıralama deterministiktir: aynı veri her zaman aynı bulguyu verir.
Kaynak metriklerini grafiklerde göstermek (overlay)
Koşu sayfasında Kaynak metriklerini grafiklerde göster:
- Kutuyu işaretleyin.
- Kaynak serisi listesinden bir seri seçin (Prometheus kaynak sorgusu ya da OTLP metriği; sayaçlar saniyedeki artışıyla).
- Seri koşunun kendi grafiklerine — istek hızı, VU, yanıt süresi, hata oranı — kesikli çizgi olarak, kendi sağ ekseninde ve zamanla hizalı çizilir; her yük basamağının başı noktalı dikey çizgiyle işaretlenir.
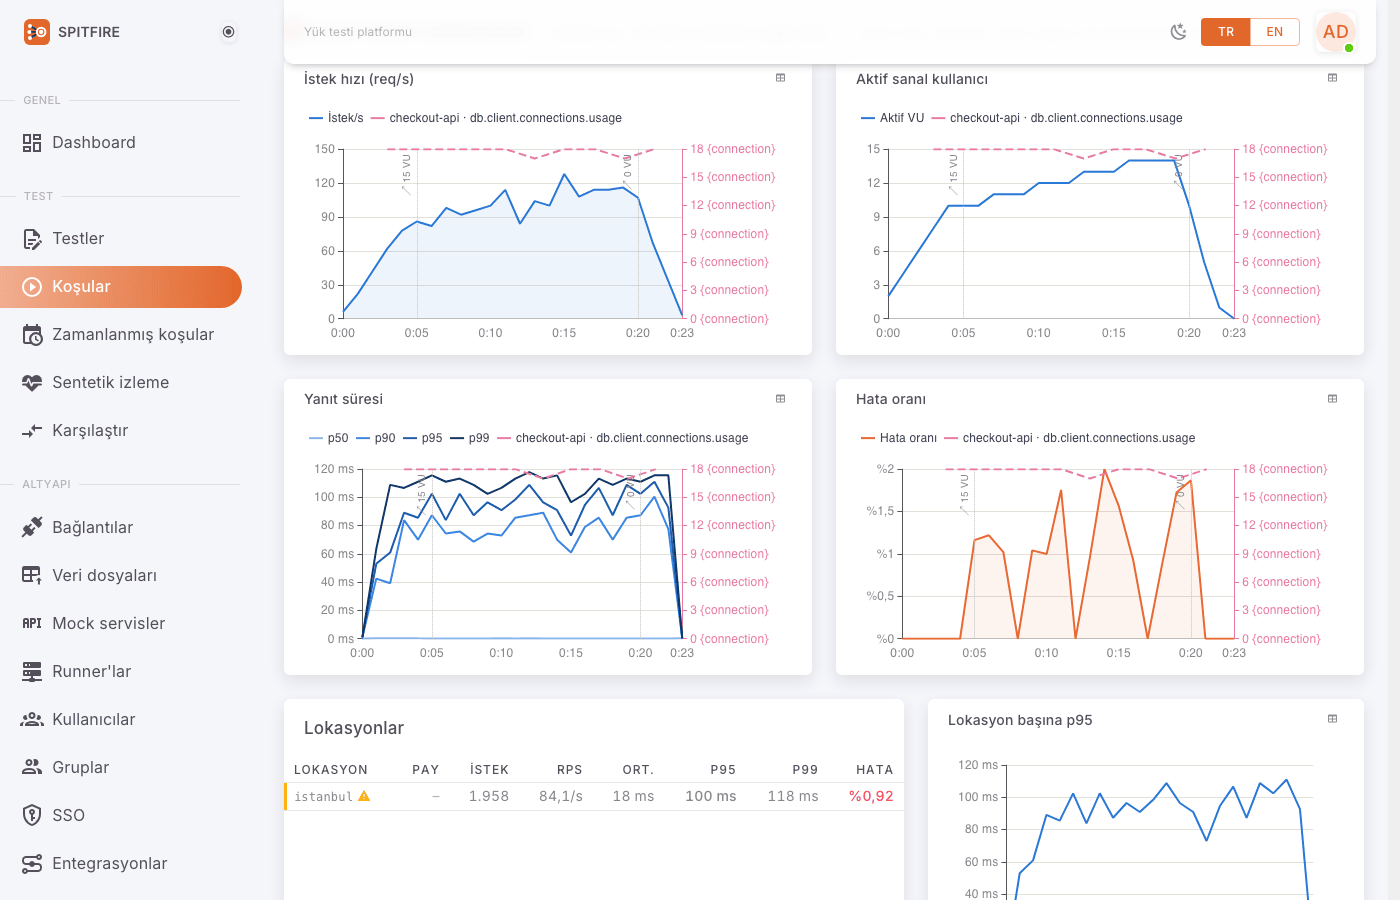 Kaynak overlay'i
"Yanıt süresi tam CPU %90'ı geçtiğinde mi fırladı?" sorusunun cevabını tek grafikte görürsünüz.
Saklama
OTLP ile gelen ham veri koşu loglarıyla birlikte budanır; hesaplanan sonuç (Backend sekmesi, bulgular) koşuyla kalır. Bir bağlantıyı kaldırmak geçmiş koşular için saklanan veriyi silmez.
Sık karşılaşılan sorunlar
| Belirti | Neden | Çözüm |
|---|---|---|
| Bu test için observability bağlantısı yok | Hiç bağlantı tanımlanmamış | Bir yönetici Observability sayfasından bağlantı ekler (Gözlemlenebilirliği ayarla). |
| Bu koşunun penceresinde backend verisi yok | Collector göndermiyor ya da sorgular bu zaman için boş | Collector loglarına bakın; anahtar doğru mu (Authorization: Bearer sfotlp_…), endpoint /otlp ile mi bitiyor? Sorgu bağlantısında Bağlantıyı dene'ye basın. |
Collector 401 alıyor |
Anahtar yanlış ya da Yeni anahtar ile değiştirildi | Collector'daki header'ı güncel anahtarla değiştirin. |
| Listede hep "x saklanmadı" | Veri koşu penceresinin dışında geliyor ya da koşu başına sınır doldu | Koşu yokken gelen veri saklanmaz; bu normaldir. Sınır dolduysa Collector'da örnekleme (sampling) yapın. |
| "… okunamadı" bulgusu | Sorgu bağlantısının adresi, kimlik bilgisi ya da kiracısı yanlış | Bağlantıyı dene ile hatayı görün; Mimir'de /prometheus önekini ve Kiracı'yı kontrol edin. |
| Gecikme sorgusu boş | Metrik adı sisteminizde farklı | Sorguyu önce Grafana/Prometheus'ta deneyin; $__interval yerine bir süre yazarak test edin. |
| "Testin istekleri trace'lerde bulunamadı" | Servisler traceparent almıyor ya da sampling bu trace'leri düşürüyor |
Context propagation'ı ve sampler'ı kontrol edin (parent-based sampler sampled bayrağına uyar). |
| "Test traceparent header'ı göndermiyor…" | Testin traceparent seçeneği kapalı | Seçenekler sekmesinde traceparent header'ı → Açık. |
| Kırılma noktası bulgusu "o an için kaynak verisi yoktu" diyor | CPU, bellek, pool, kuyruk metriği yok | Prometheus Kaynak sorguları ya da Collector'dan OTLP metrikleri ekleyin. |
| Overlay'de seri yok | Kaynak sorgusu ya da OTLP metriği yok | Kaynak türünde sorgu ekleyin; koşu bittikten sonra 90 sn bekleyin. |
| Trace backend'i doldu | traceparent açıkken her istek trace saklatıyor |
Yalnızca gerekli testlerde açın; trace saklama süresini kısaltın. |
İlgili sayfalar
- Sürüm karşılaştırma — farkın arkasındaki backend'i görmek
- Mock, chaos ve kapasite — kırılma noktasından kapasite tahmini
- Zamanlama ve izleme — Spitfire'ın kendi metriklerini dışarı vermesi
- Sorun giderme
- Observability
Spitfire'da: /observability